Agent làm xong là quên: biến kinh nghiệm thành skill dùng lại
Một agent có thể giải quyết rất tốt một việc hôm nay, rồi lần sau gặp đúng việc ấy lại bắt đầu gần như từ đầu. Hội thoại cũ vẫn còn, nhưng kinh nghiệm nằm rải trong hàng loạt câu trả lời và lần gọi công cụ. Tìm lại được chúng chưa có nghĩa là agent biết lặp lại cách làm tốt.
Trong bài nói Turning Agent Memory Into Skills That Work, Will Lyon của Neo4j đi từ câu hỏi ấy đến một mô hình: giữ trí nhớ dưới dạng các đối tượng, quan hệ và dấu vết quyết định; sau đó chắt lọc những việc lặp lại thành skill có thể dùng ở phiên sau. Dưới đây là 13 luận điểm chính của bài, với các slide minh họa theo đúng thứ tự.
1. Agent làm xong rồi lại quên
Vòng lặp quen thuộc của agent là nhận việc, suy nghĩ, hành động, xem kết quả rồi lặp lại. Will Lyon chỉ ra một vòng lặp khác ít được nói tới: sau khi hoàn thành, kinh nghiệm có thể biến mất cùng phiên làm việc. Agent mới mở lại không tự biết tại sao lần trước chọn cách ấy và thế nào được coi là xong.
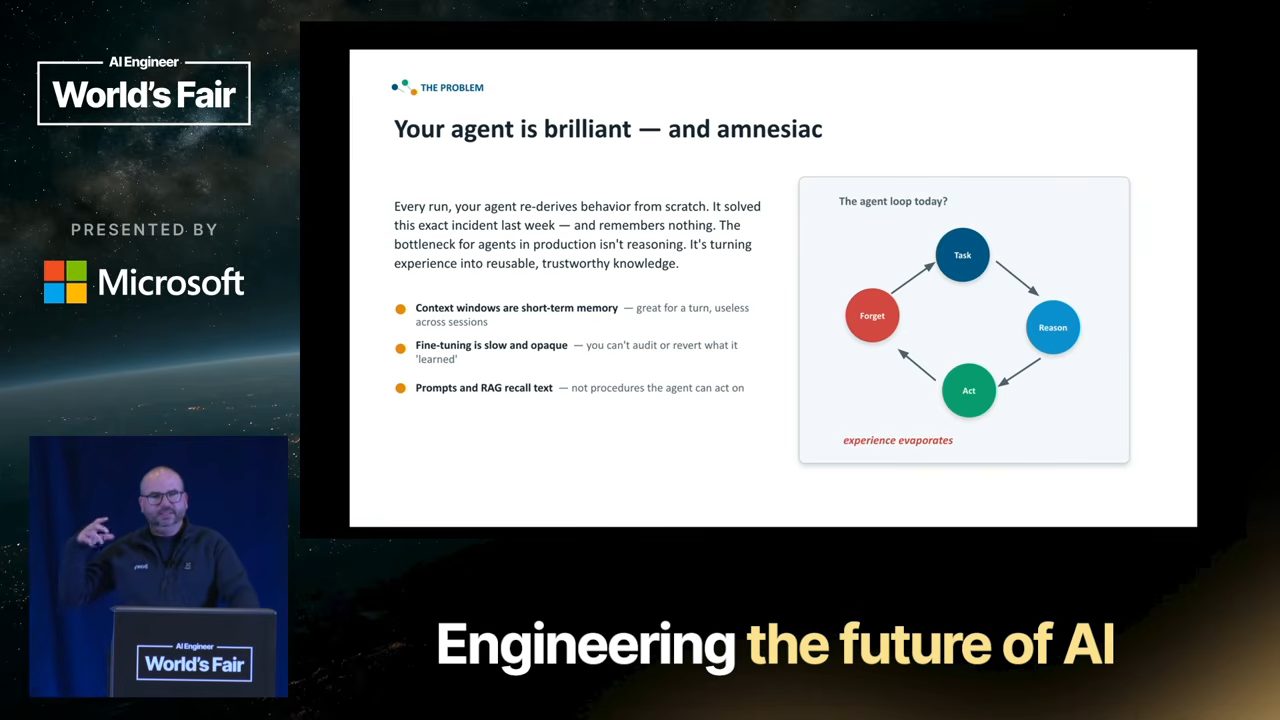
Vì vậy, vấn đề không chỉ là kéo dài cửa sổ ngữ cảnh hoặc lưu thêm hội thoại. Cần giữ được điều sẽ giúp agent hành động tốt hơn trong tình huống tương tự.
2. Nhớ lại một đoạn văn chưa phải là hiểu việc
Cách phổ biến là cắt hội thoại thành nhiều đoạn, lưu lại rồi tìm đoạn gần nghĩa với câu hỏi. Việc ấy giúp tra cứu, nhưng có thể bỏ lỡ các mối quan hệ. Trong ví dụ của Will, “Dr. Nguyen”, “Robert N.” và “the cardiologist” có thể cùng chỉ một bác sĩ; nếu chúng nằm trong ba đoạn rời, agent chưa chắc biết đó là một người.
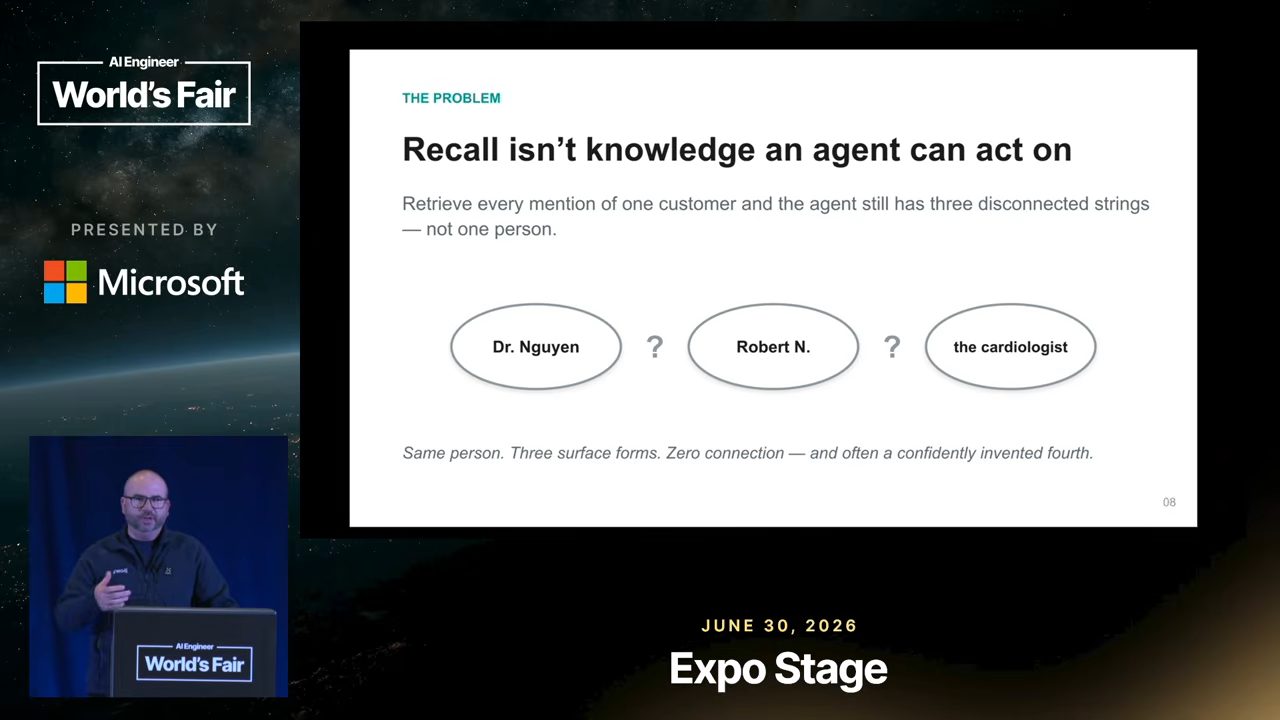
Trí nhớ hữu ích cần chỉ ra đối tượng là ai, quan hệ giữa các đối tượng là gì và mỗi kết luận đến từ nguồn nào. Tìm đúng câu chữ là bước đầu, chưa phải kiến thức có thể dùng để ra quyết định.
3. Ba loại trí nhớ bổ sung cho nhau
Theo mô hình được trình bày, agent có ba lớp trí nhớ. Ngắn hạn giữ tin nhắn của cuộc trò chuyện hiện tại. Dài hạn giữ những người, nơi chốn, sự kiện và quan hệ được rút ra từ nhiều cuộc trò chuyện. Trí nhớ suy luận giữ cách agent đã quyết định và thực hiện công việc. Neo4j gọi mạng lưới kết nối các lớp này là context graph.
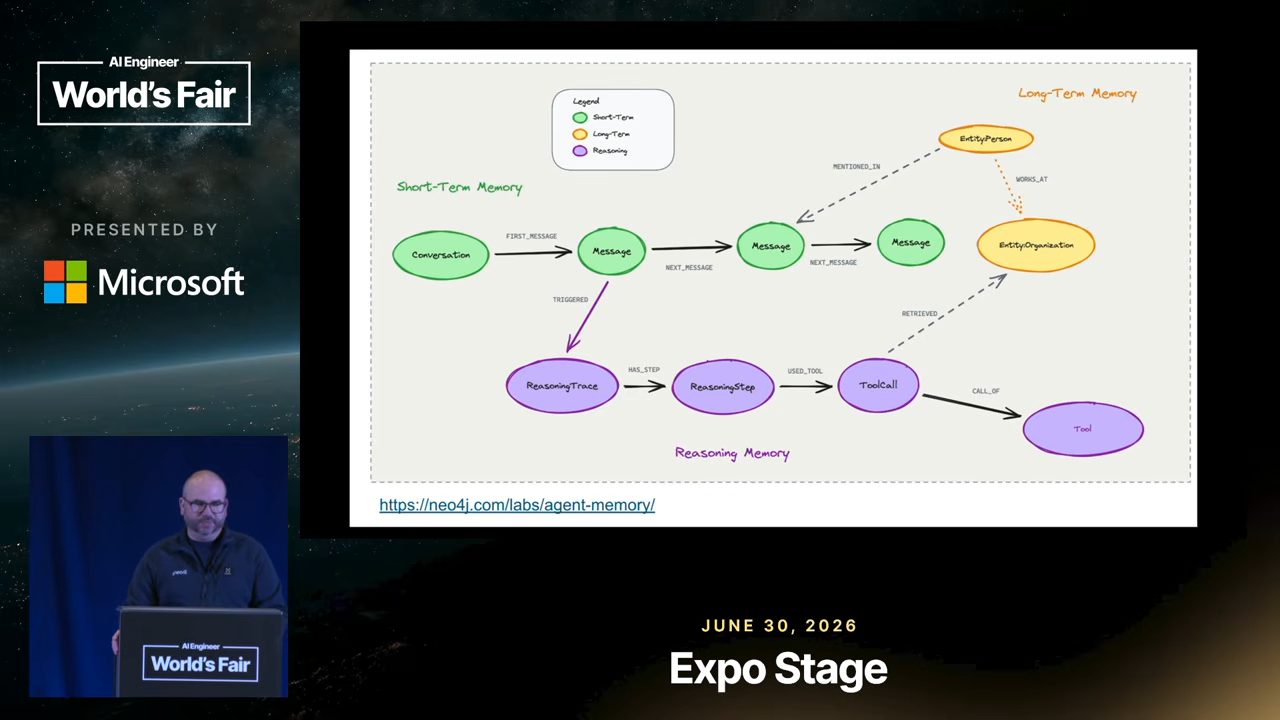
Một kho đoạn văn có thể trả lời “đã nói gì?”. Context graph còn hướng tới câu hỏi “những điều ấy liên quan thế nào?” và “lần trước đã xử lý ra sao?”.
4. Biến hội thoại thành một mạng lưới có cấu trúc
Hệ thống đọc hội thoại, nhận diện các đối tượng và tạo quan hệ rõ nghĩa giữa chúng: ai là bác sĩ, ai là bệnh nhân, cuộc khám nào liên quan đến ai. Bước gộp trùng đối tượng giúp nhiều cách gọi cùng trỏ về một người hoặc một sự việc.
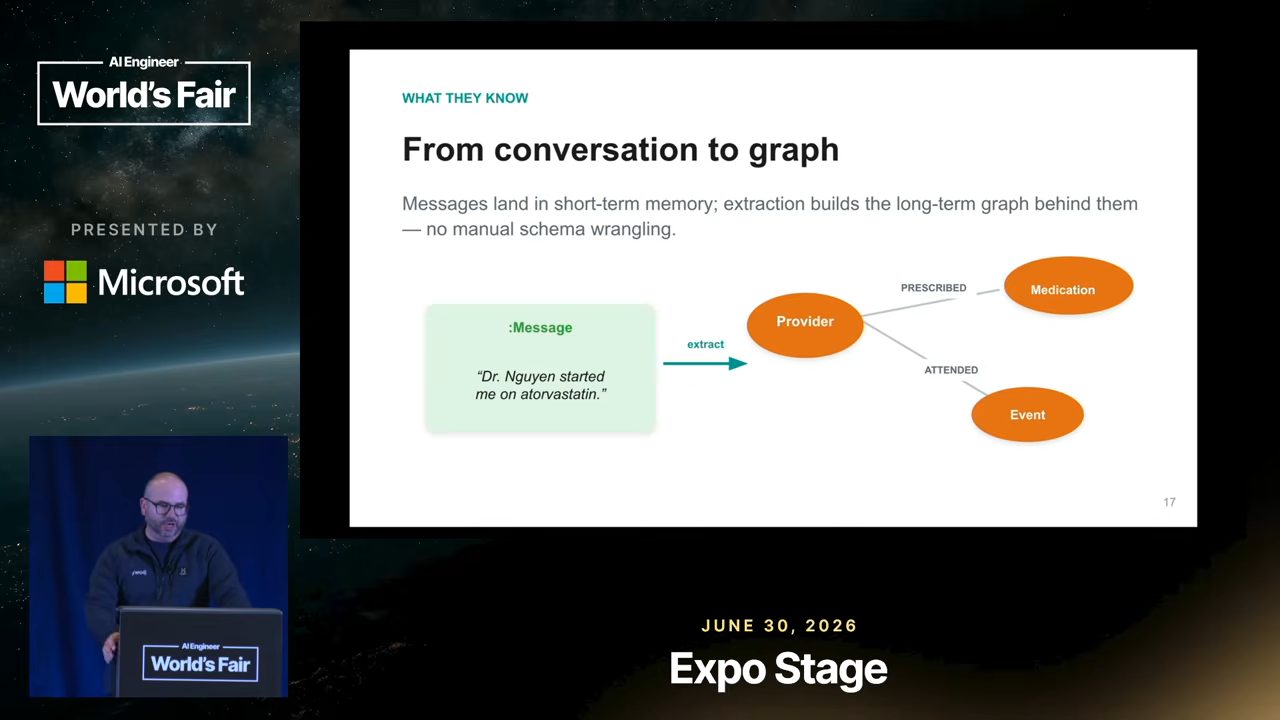
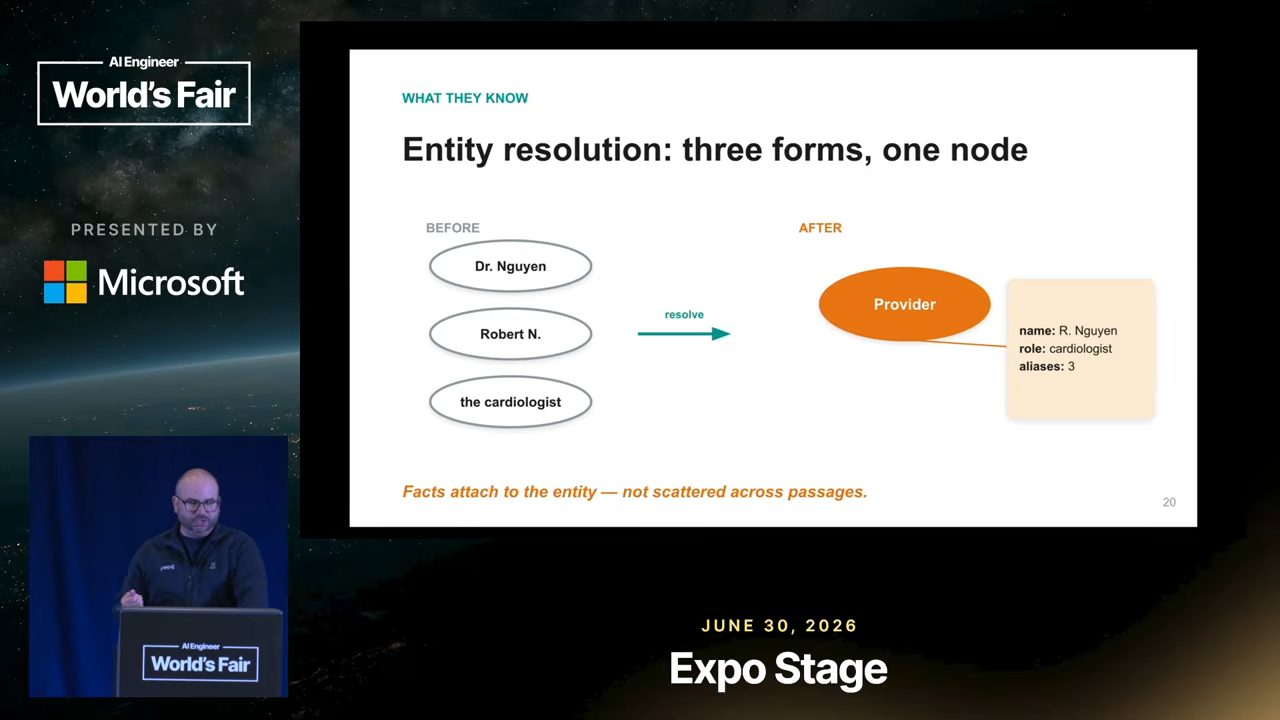
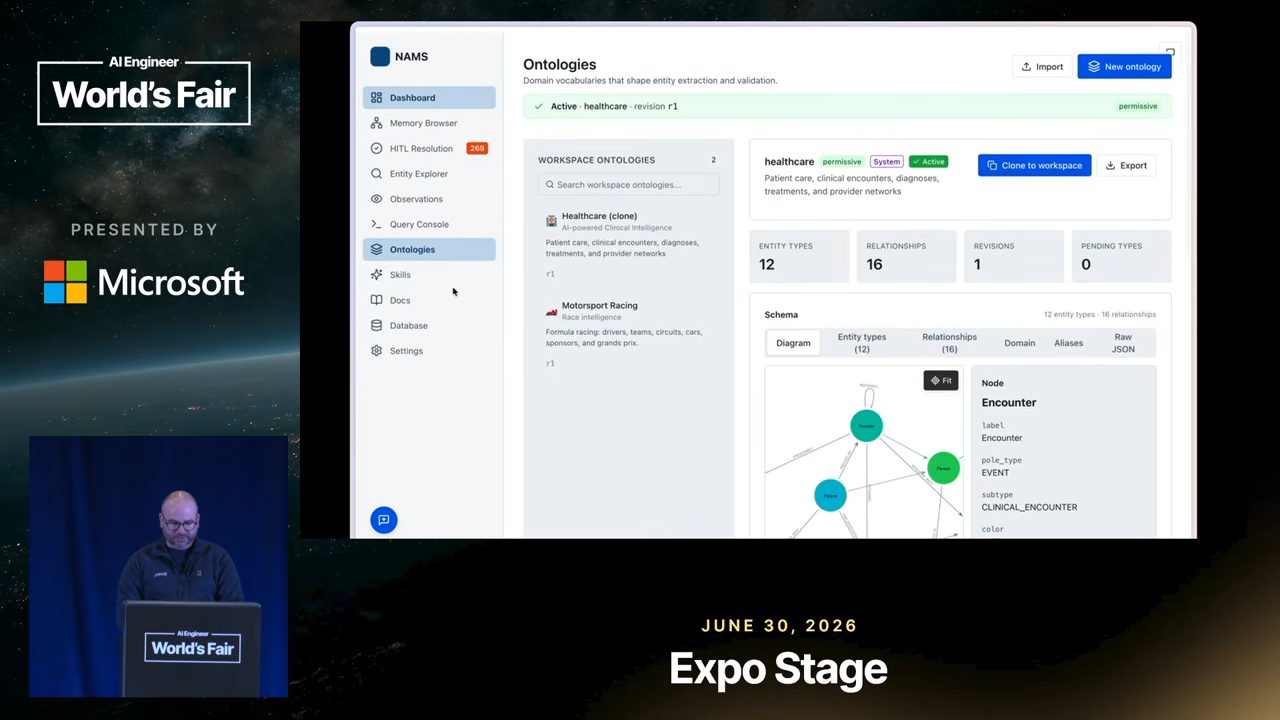
Muốn làm nhất quán, hệ thống cần một bộ khung cho từng lĩnh vực (ontology): có những loại đối tượng nào, quan hệ nào hợp lệ và thông tin nào là bằng chứng. Bộ khung của y tế sẽ khác bộ khung quản lý dự án hay chăm sóc khách hàng. Đây cũng là lý do không thể chỉ ném toàn bộ tài liệu vào một chỗ rồi chờ agent tự hiểu.
5. Ghi lại cả đường đi tới quyết định
Trí nhớ về nội dung chưa đủ. Nếu agent từng giải quyết một việc tốt, ta cần biết nó dựa vào bằng chứng nào, áp dụng quy định nào, gọi công cụ gì và công cụ trả về kết quả gì. Will gọi phần ấy là decision trace — dấu vết quyết định.
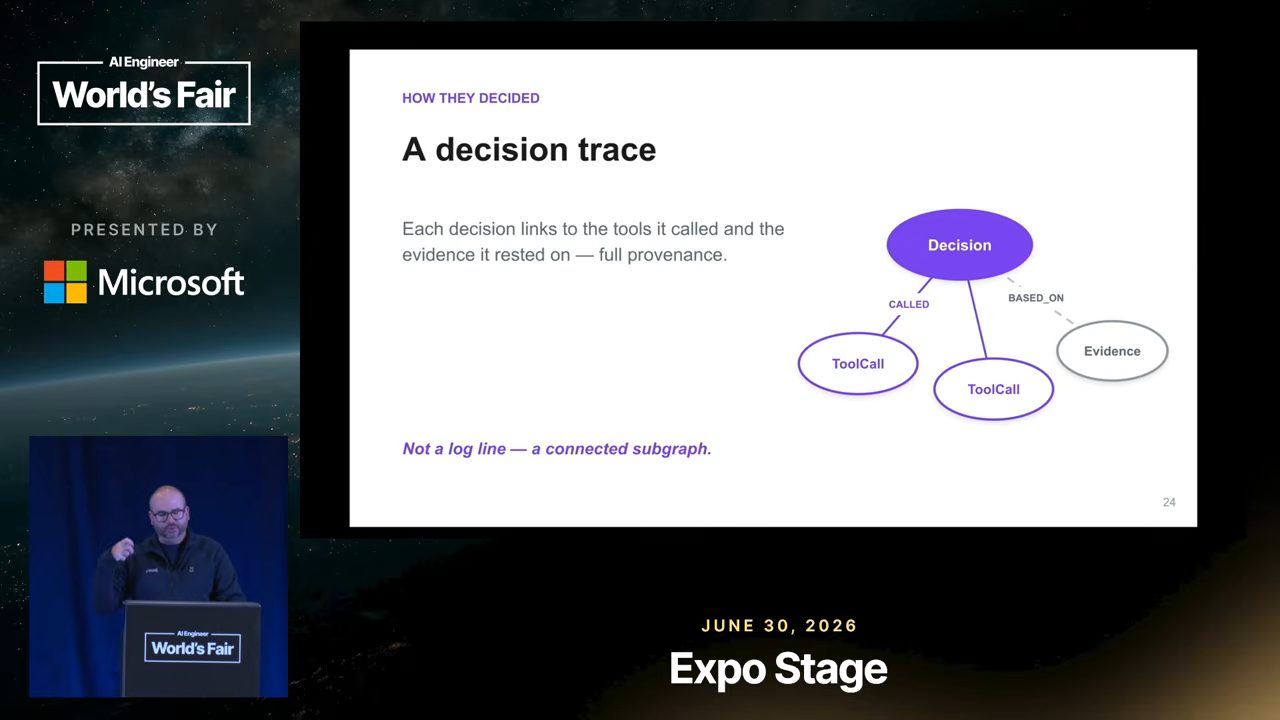
Dấu vết ấy còn có thể ghi thời gian và chi phí thực hiện. Giá trị chính không phải một bảng log thật dài, mà là khả năng lần ngược: khi một bước sai, biết nó sai ở dữ liệu đầu vào, ở quyết định hay ở công cụ đã dùng.
6. Trí nhớ không nên bị nhốt trong một phiên chạy
Nếu nhiều agent cùng làm việc trong một tổ chức, kinh nghiệm của agent này có thể hữu ích cho agent khác. Trong mô hình Will giới thiệu, các dấu vết được lưu vào một không gian chung và chỉ agent có quyền mới truy cập được. Một phiên làm việc mới có thể tìm lại kết quả cùng con đường đi tới kết quả ấy.
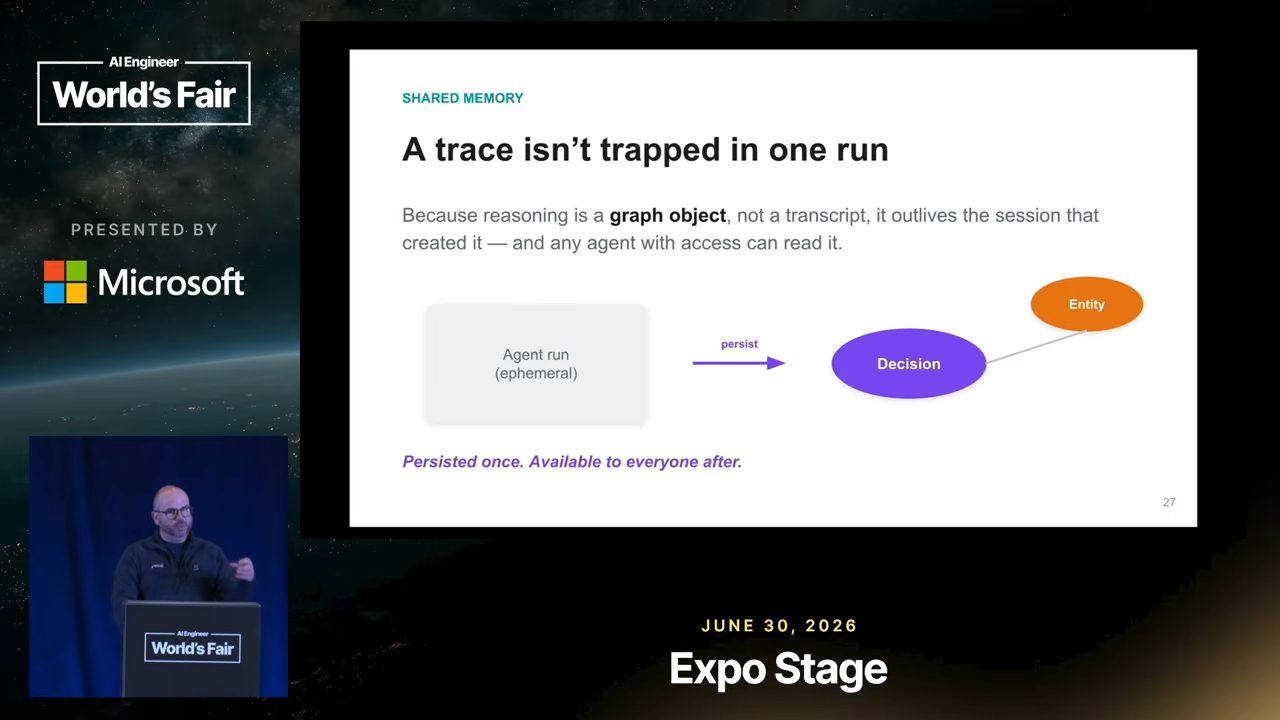
Điều này mở ra khả năng học chung, nhưng cũng đặt ra yêu cầu về quyền truy cập và chất lượng dữ liệu: một quyết định sai được chia sẻ rộng sẽ làm nhiều agent sai theo.
7. Từ trí nhớ sang skill có thể thực hiện
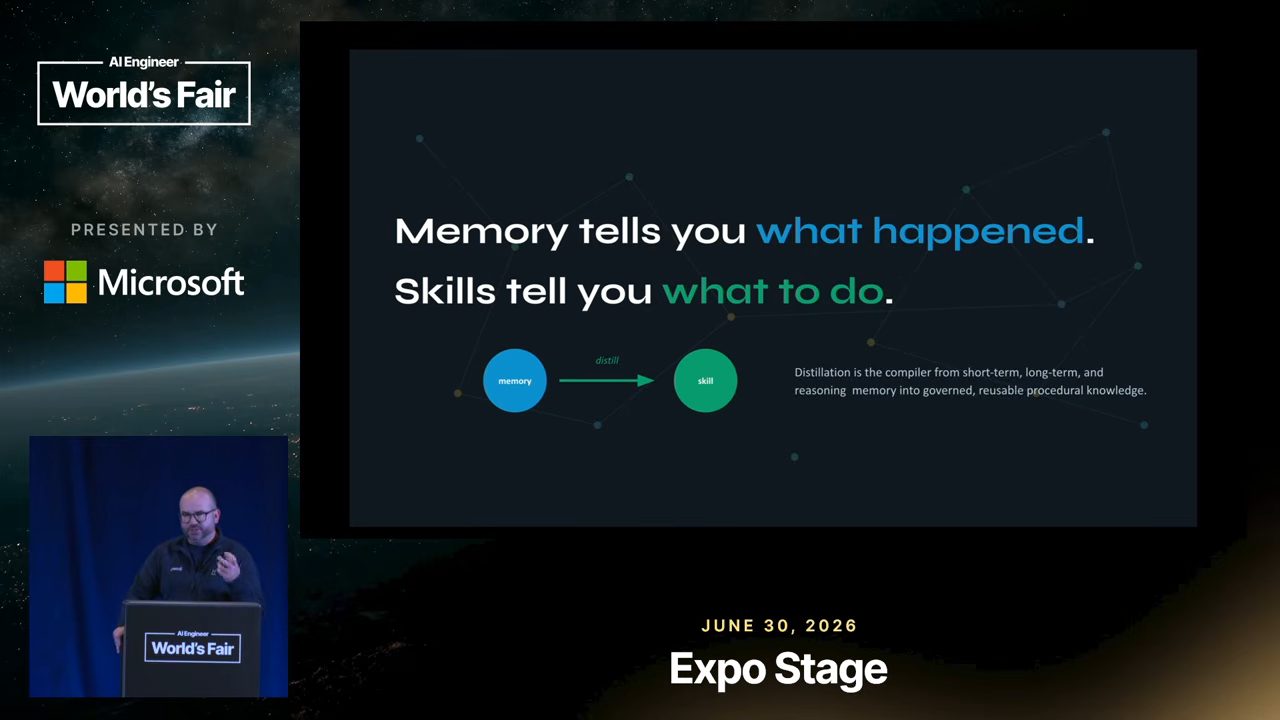
Will phân biệt rất gọn: trí nhớ kể chuyện đã xảy ra; skill chỉ cách làm. Một skill mô tả khi nào nên dùng, các bước cần thực hiện, tài liệu tham chiếu và điều kiện hoàn tất. Agent có thể nạp phần hướng dẫn phù hợp khi cần, thay vì phải đọc lại toàn bộ lịch sử.
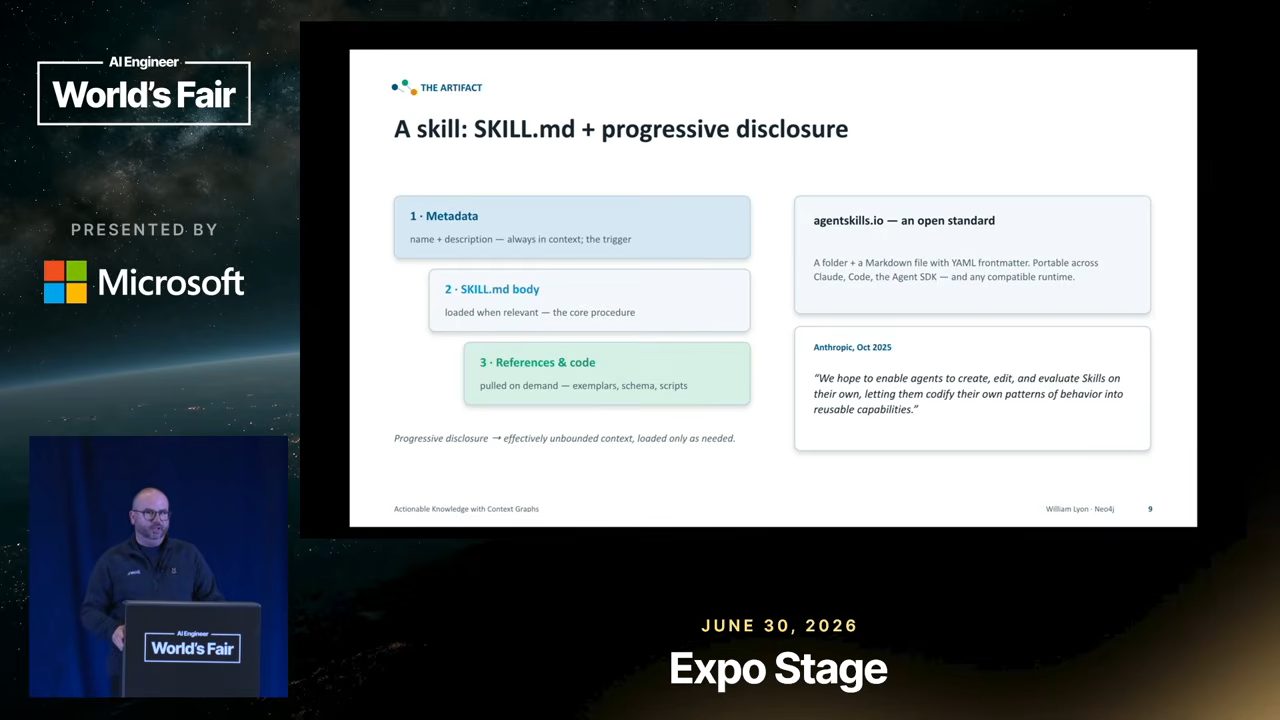
Cách đóng gói này cũng cho phép tách hướng dẫn ngắn khỏi tài liệu chi tiết: cần tới đâu mở tới đó. Nhưng một file hướng dẫn chỉ có chữ vẫn có giới hạn của nó.
8. Skill viết bằng văn xuôi khó kiểm tra từng bước
Văn xuôi dễ viết và dễ đọc. Song khi quy trình có nhánh, điều kiện, công cụ và đầu ra cụ thể, một đoạn dài có thể để lại nhiều chỗ phải tự diễn giải. Muốn biết bước nào thất bại hoặc sửa đúng một bước, ta cần cấu trúc rõ hơn.
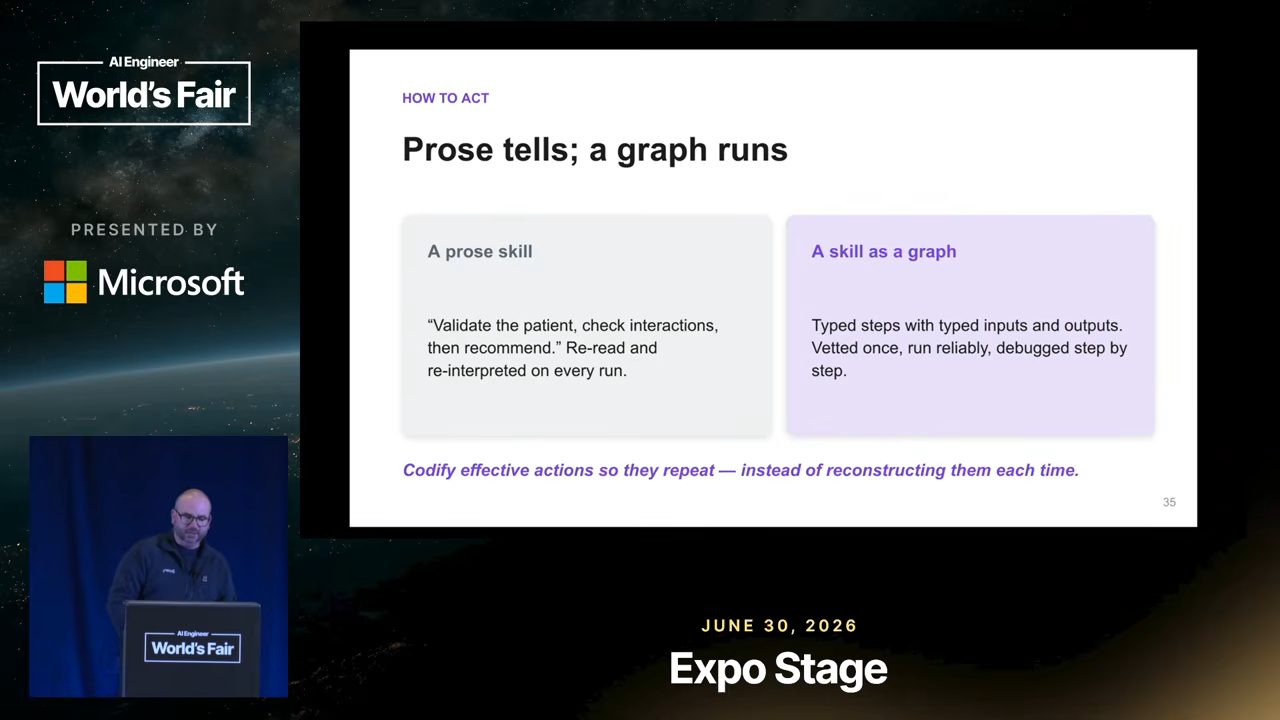
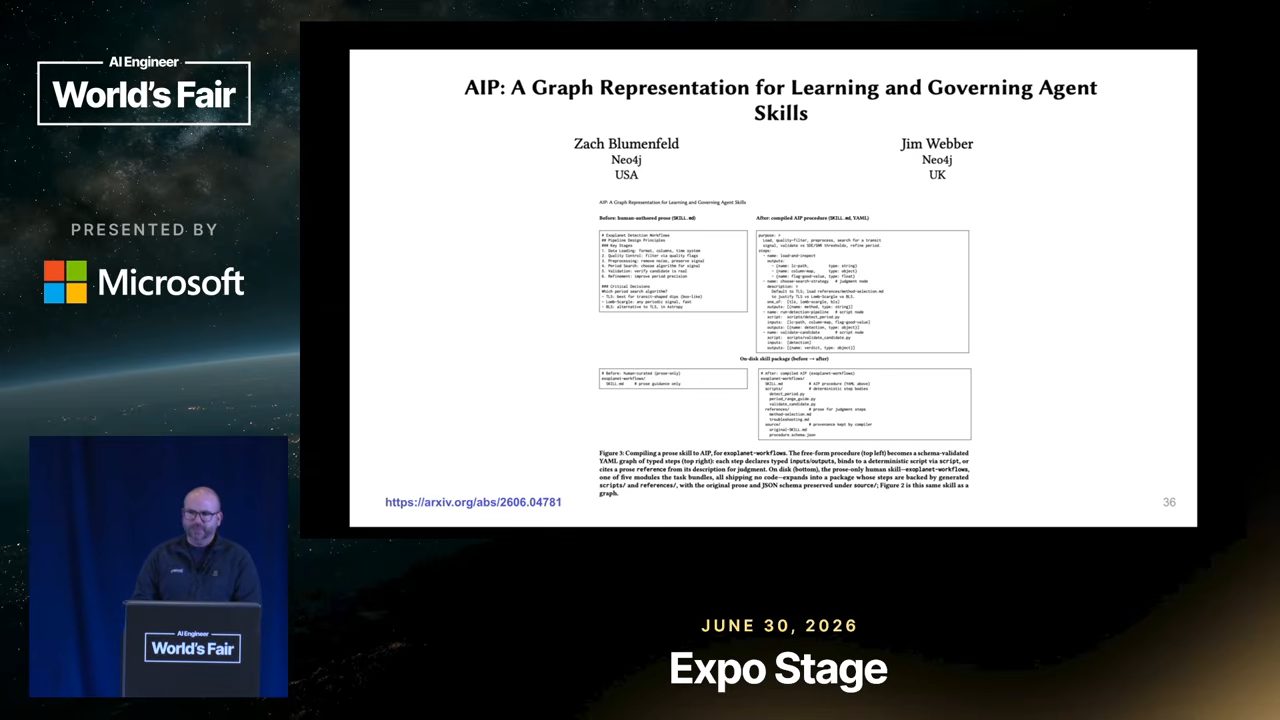
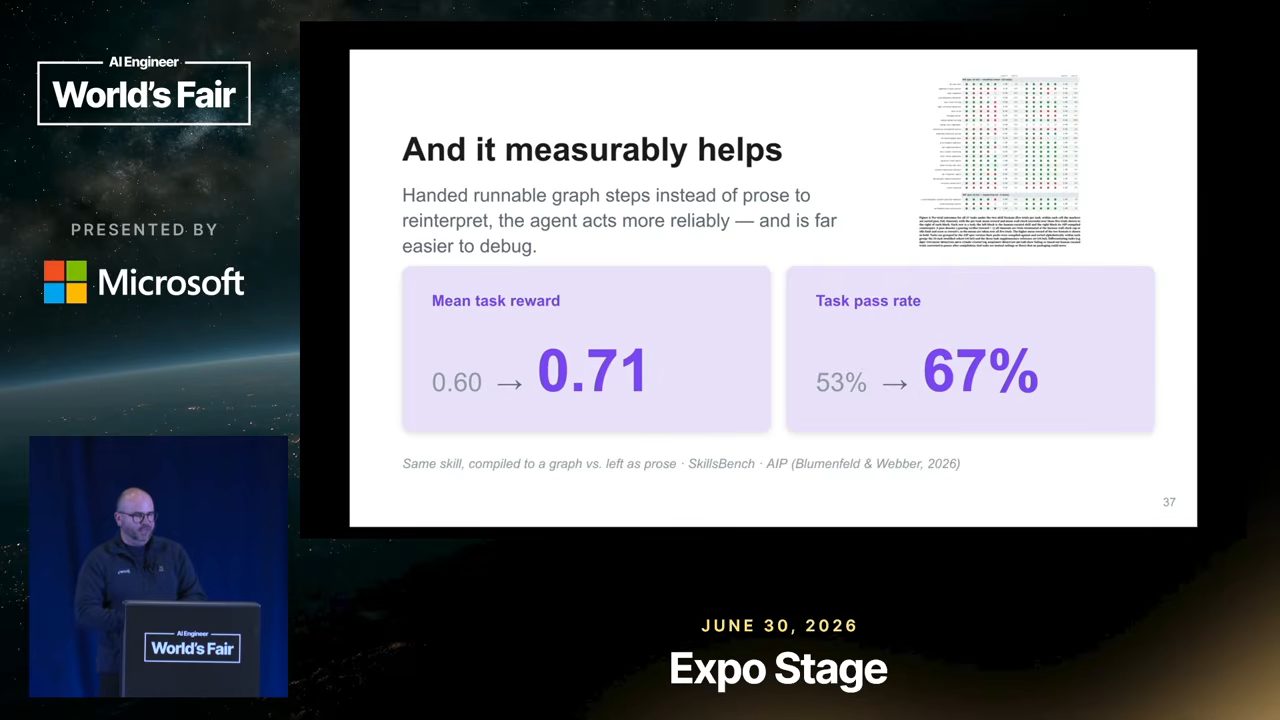
Nghiên cứu Agent Instruction Protocol (AIP) đề xuất biểu diễn skill thành đồ thị gồm các bước có kiểu, đầu vào, đầu ra và quan hệ phụ thuộc. Bài viết của Neo4j dẫn kết quả thử nghiệm của nhóm tác giả trên SkillsBench: tỉ lệ hoàn thành tăng từ 53,3% với skill văn xuôi lên 67,4% với dạng có cấu trúc. Đây là kết quả trong bộ kiểm tra của nghiên cứu, không phải lời bảo đảm mọi skill chuyển sang đồ thị đều tốt hơn.
9. Rút skill từ trí nhớ phải qua những phép kiểm tra
Không nên lấy một lần làm việc rồi coi đó là quy trình chuẩn. Will mô tả ba câu hỏi kiểm tra trước khi đóng gói skill: Có căn cứ không? Mỗi bước có dẫn về dữ liệu và thao tác thật hay chỉ là AI suy ra? Đủ bao phủ không? Toàn bộ quy trình có bằng chứng hay chỉ vài bước đầu? Đúng một chủ đề không? Nếu trộn nhiều việc, nên tách thành những skill nhỏ hơn.
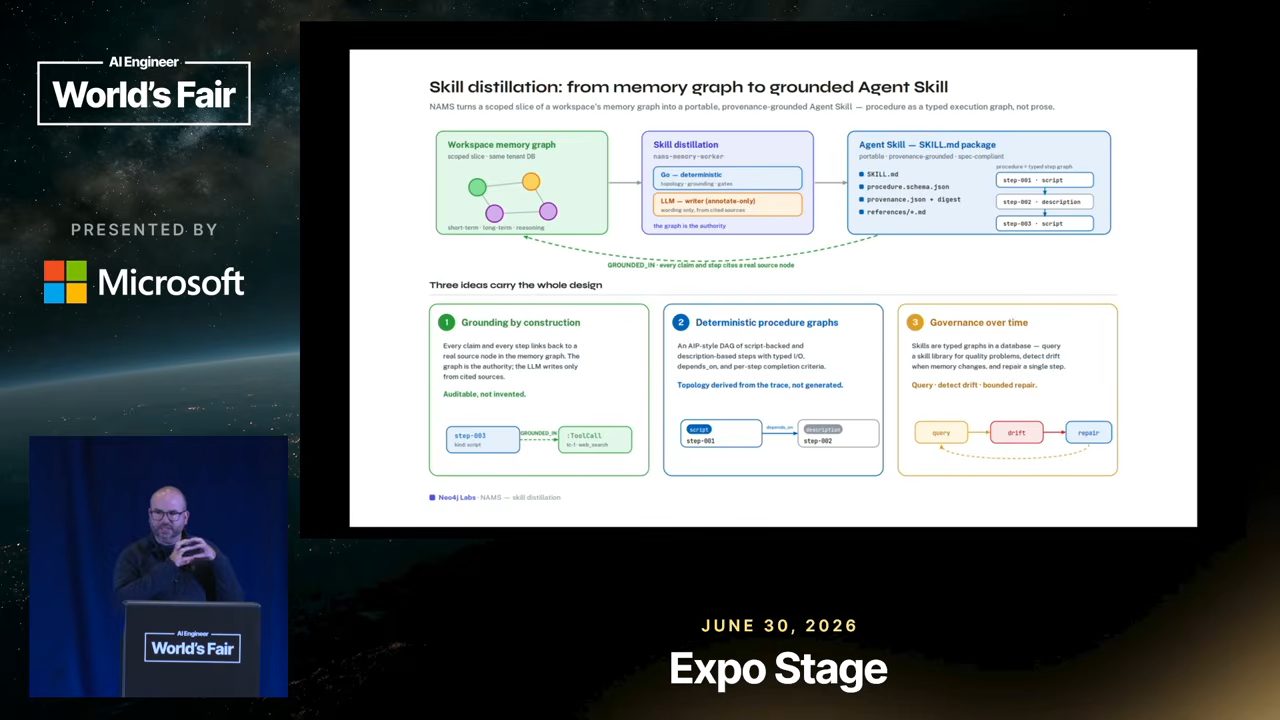
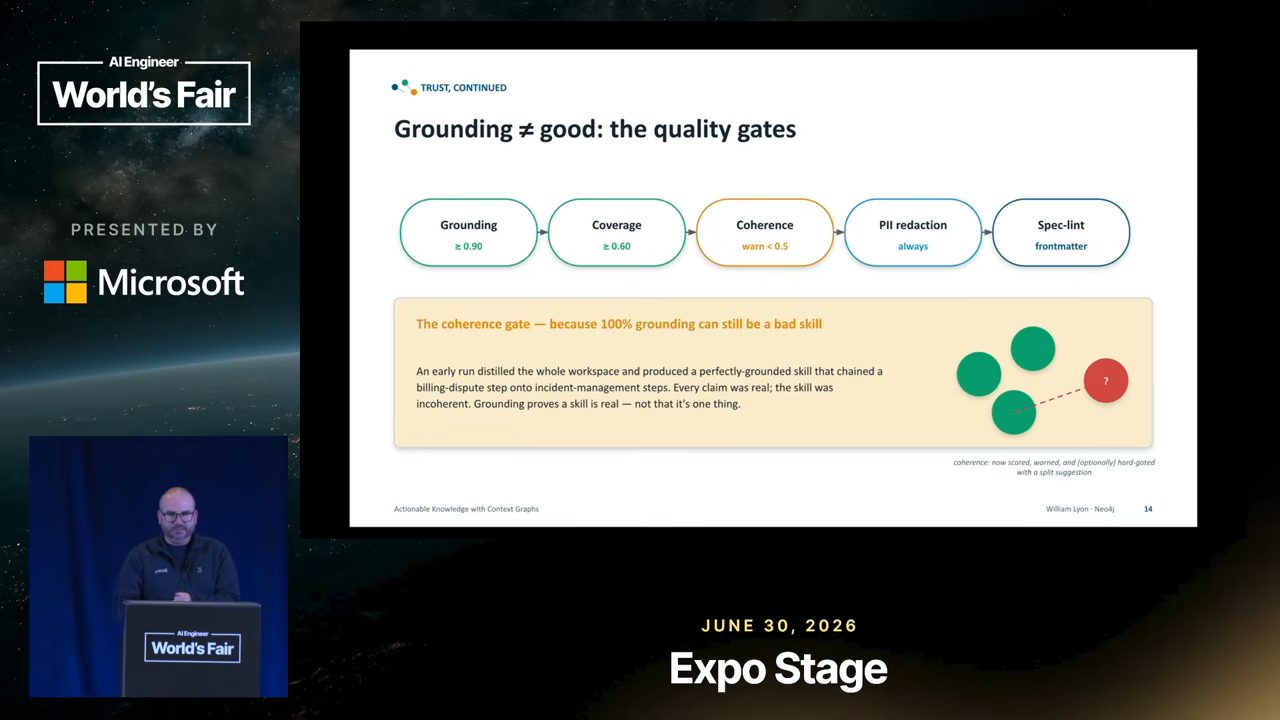
Ngoài ba câu hỏi ấy còn có kiểm tra định dạng và dữ liệu cá nhân. Một skill trông hợp lý nhưng lộ thông tin riêng hoặc chứa bước không có căn cứ thì chưa nên đưa vào dùng.
10. Skill cần người duyệt và cần biết khi nào đã cũ
Một quy trình đúng hôm nay có thể sai khi quy định, dữ liệu gốc hoặc công cụ thay đổi. Trong cách Neo4j mô tả, skill được tạo ra ở trạng thái chờ xem xét. Người phụ trách có thể lần theo bằng chứng của từng bước để duyệt hoặc từ chối. Sau khi phát hành, hệ thống theo dõi drift: bước nào không còn khớp với dữ liệu hoặc công cụ hiện tại.
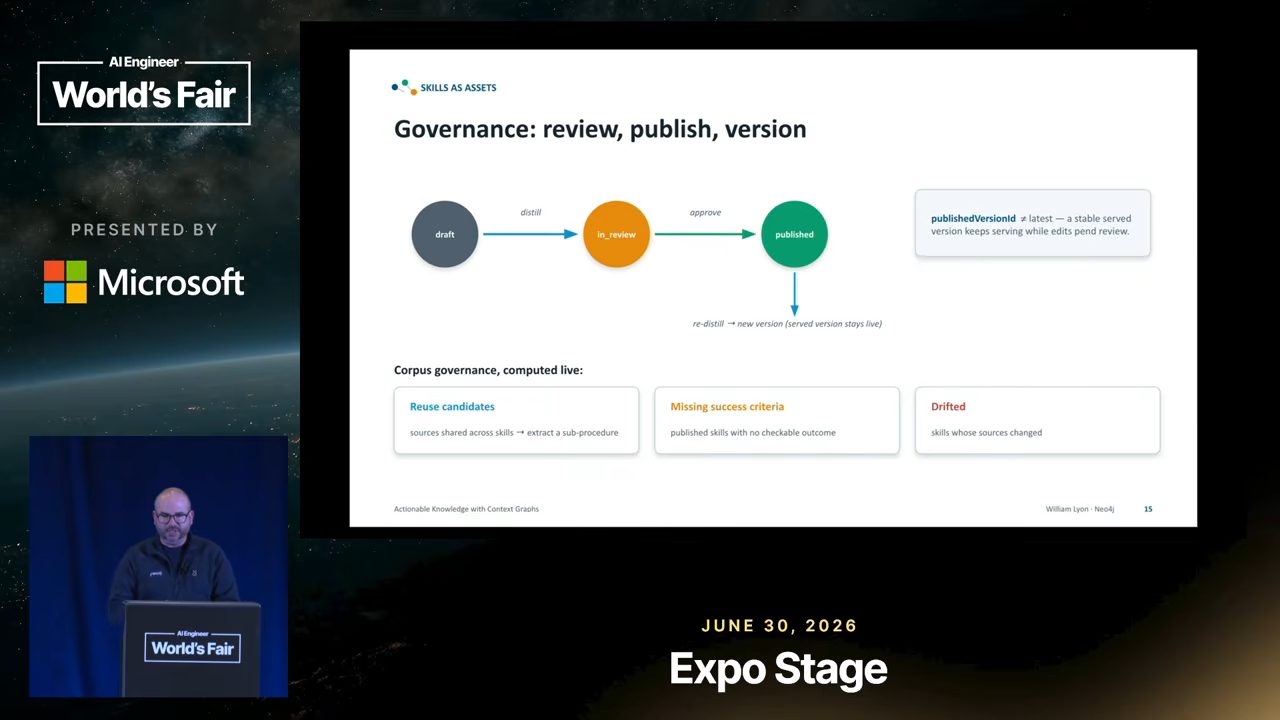
Ý quan trọng ở đây là cập nhật có kiểm soát. Không nên để agent tự sửa quy trình rồi âm thầm áp dụng bản mới cho mọi người.
11. Một quy trình bảy bước để chắt lọc skill
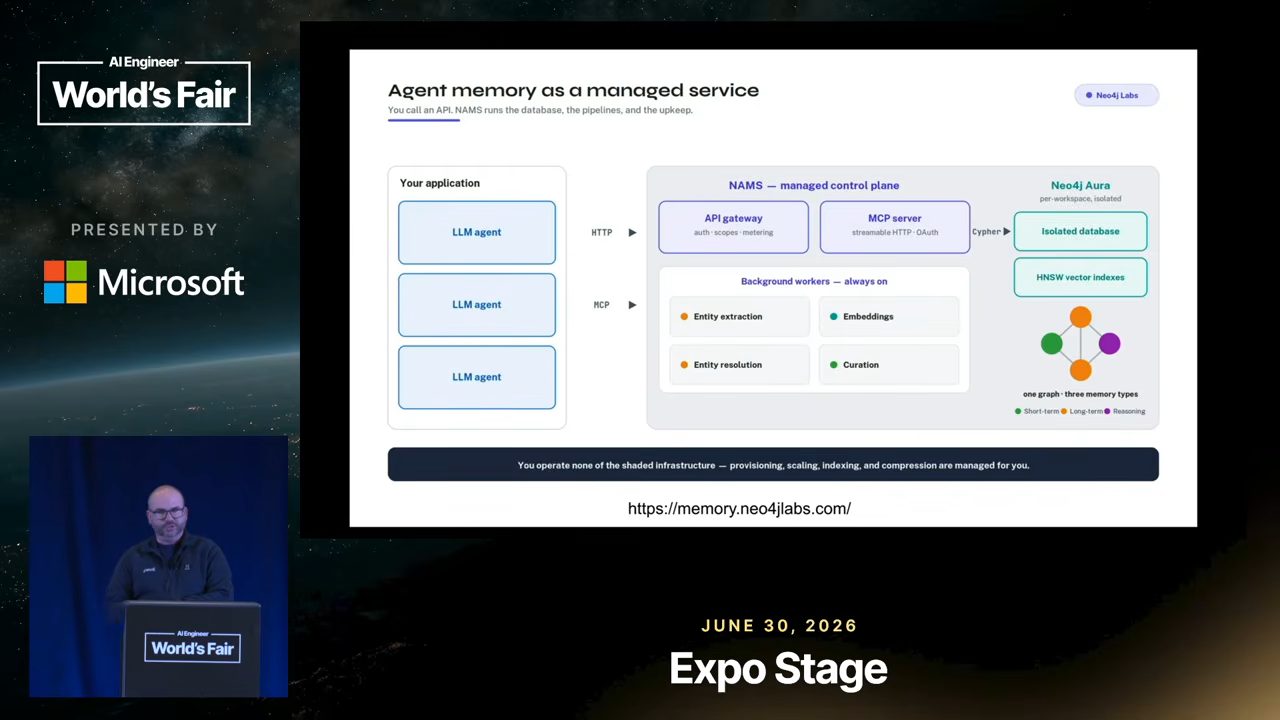
Neo4j giới thiệu NAMS — dịch vụ lưu trí nhớ agent. Theo bài viết kỹ thuật của Will Lyon, việc rút skill gồm bảy giai đoạn: chọn phạm vi, chụp trạng thái dữ liệu, gộp các mẫu hành động lặp lại, dựng đồ thị bước, tổng hợp mô tả, chạy các cổng kiểm tra và lưu gói kết quả.
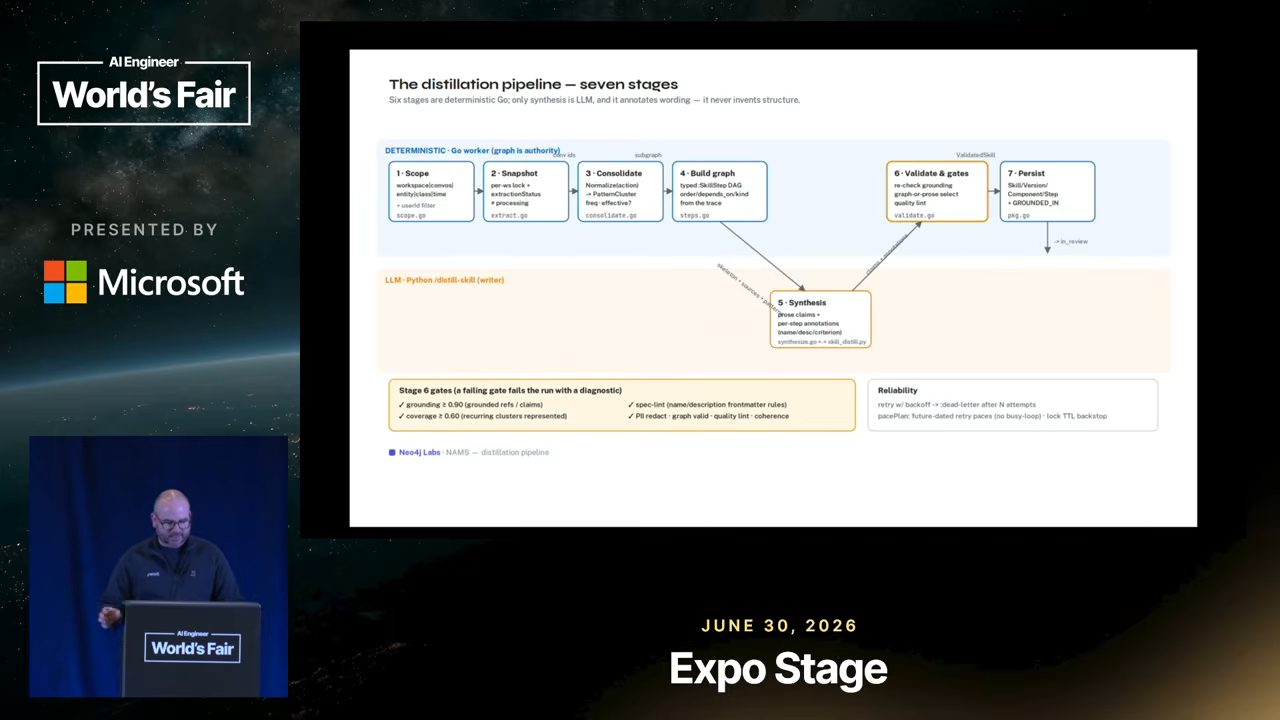
Điểm đáng chú ý: phần lớn giai đoạn dựa trên quy tắc và dấu vết đã ghi; AI tập trung ở phần viết mô tả cho các bước. Mỗi phần của skill gắn với nguồn gốc của nó để có thể kiểm tra và biết khi nào cần làm lại.
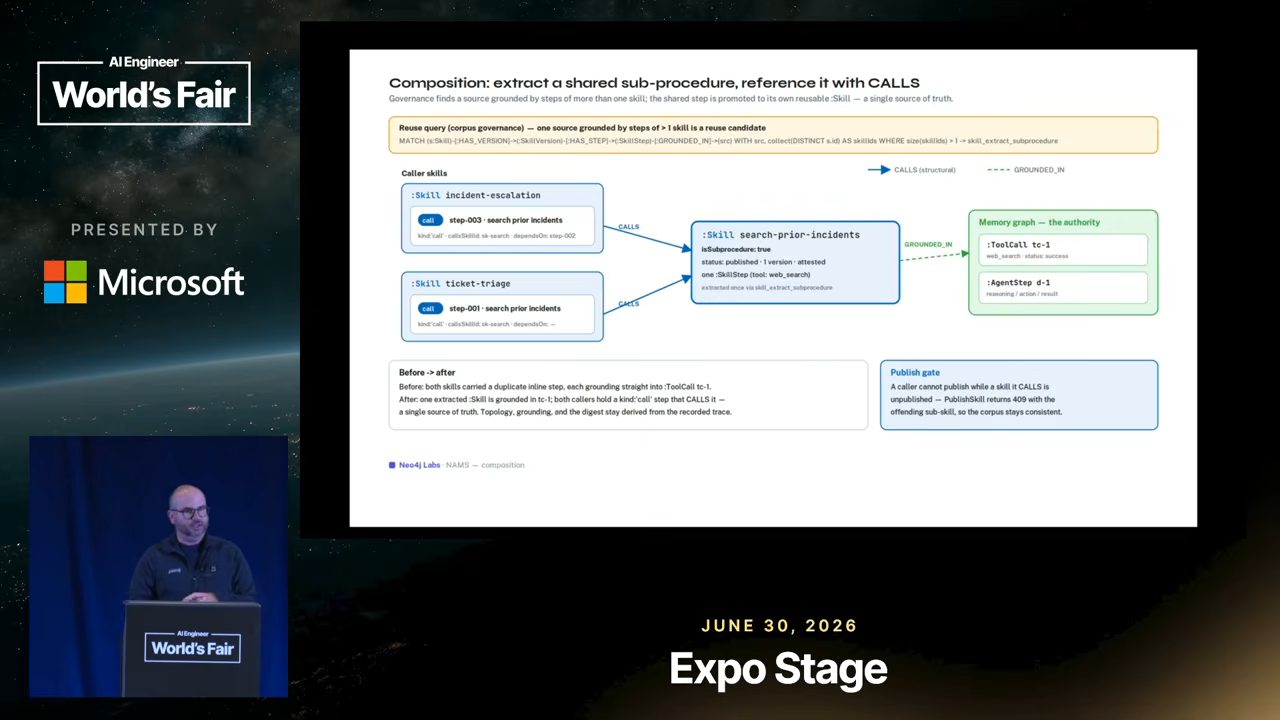
Một quy trình lớn cũng có thể dùng lại quy trình con. Nếu nhiều skill đều cần bước “xác minh thông tin đầu vào”, bước ấy có thể thành skill riêng để gọi lại, thay vì chép nhiều bản rồi sửa sót một nơi.
12. Demo tiếp nhận bệnh nhân cho thấy điều gì?
Trong phần demo, Will dùng một bối cảnh y tế đã được dựng sẵn. Trước tiên hệ thống có bộ khung đối tượng như bác sĩ, bệnh nhân và lần khám. Người dùng chọn phạm vi trí nhớ để rút skill — có thể là vài hội thoại hoặc những gì liên quan đến một loại đối tượng — rồi chạy quy trình chắt lọc.
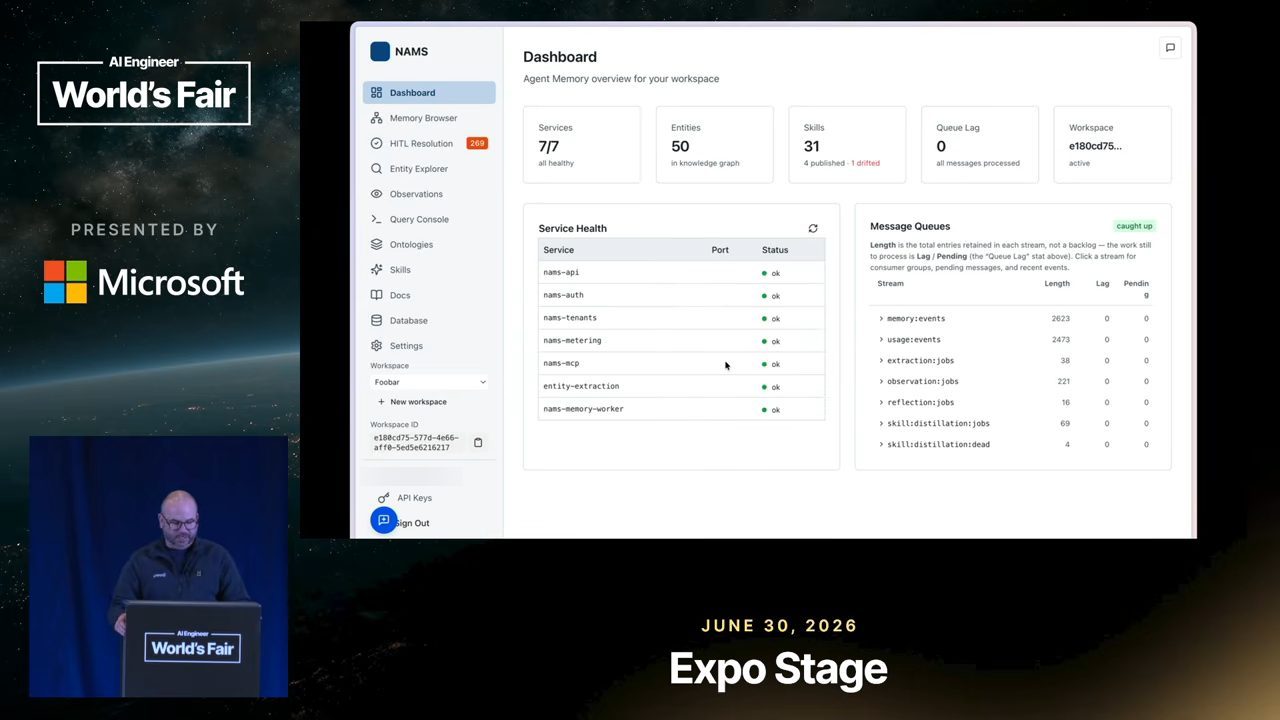
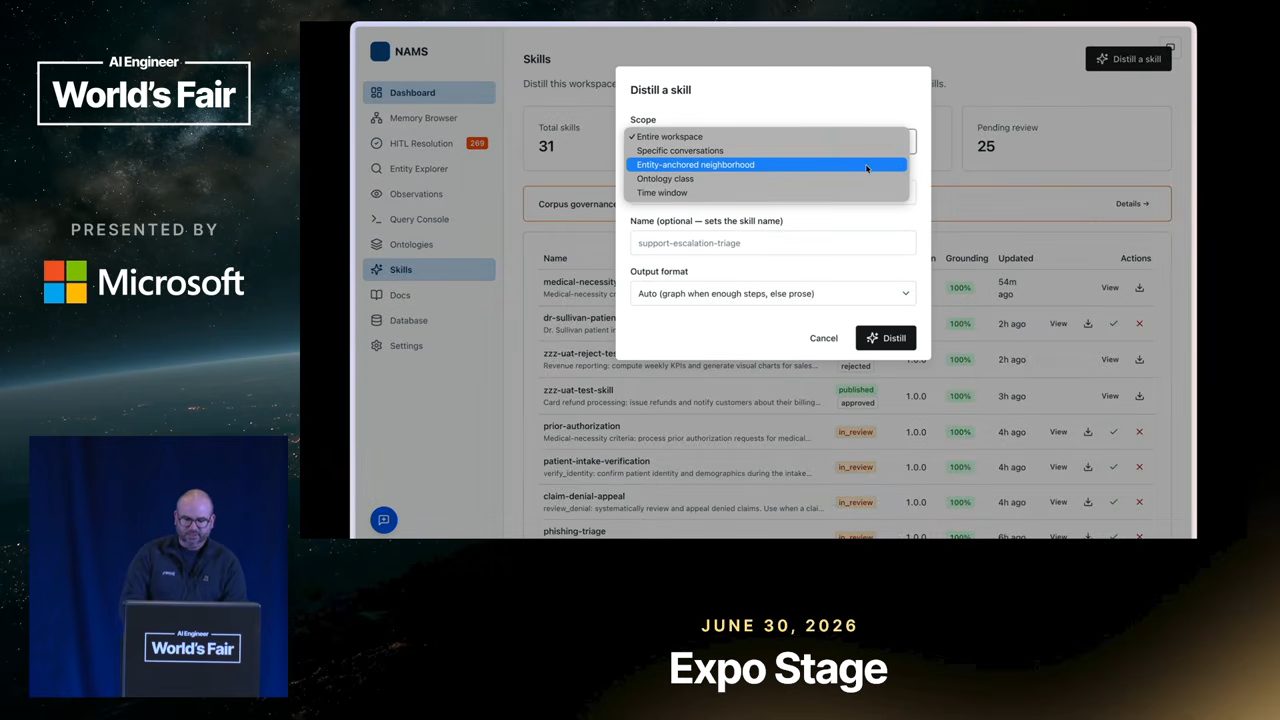
Skill tiếp nhận bệnh nhân được trình bày thành các bước như kiểm tra thông tin bảo hiểm, xác minh, đặt lịch và tạo hồ sơ. Mỗi bước có liên kết với công cụ hay dữ liệu đã xuất hiện trong các lần làm việc trước. Kết quả có thể được đóng gói thành file SKILL.md cùng tài liệu tham chiếu.
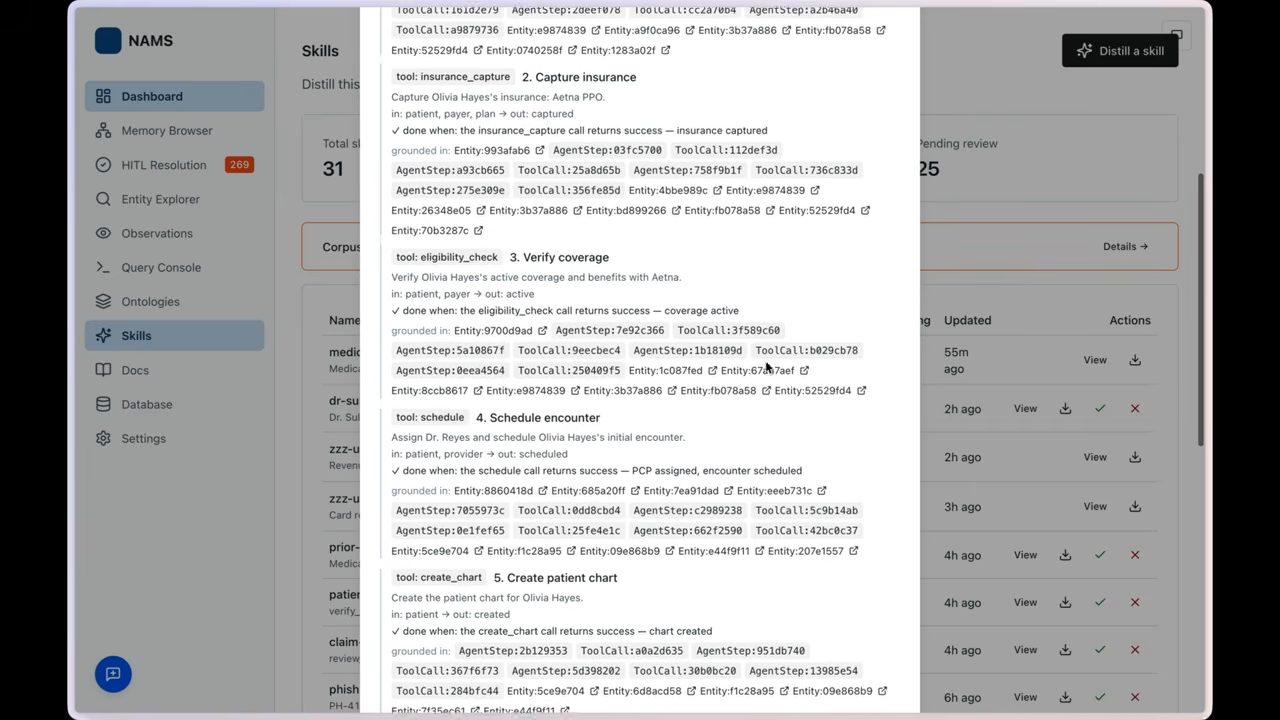
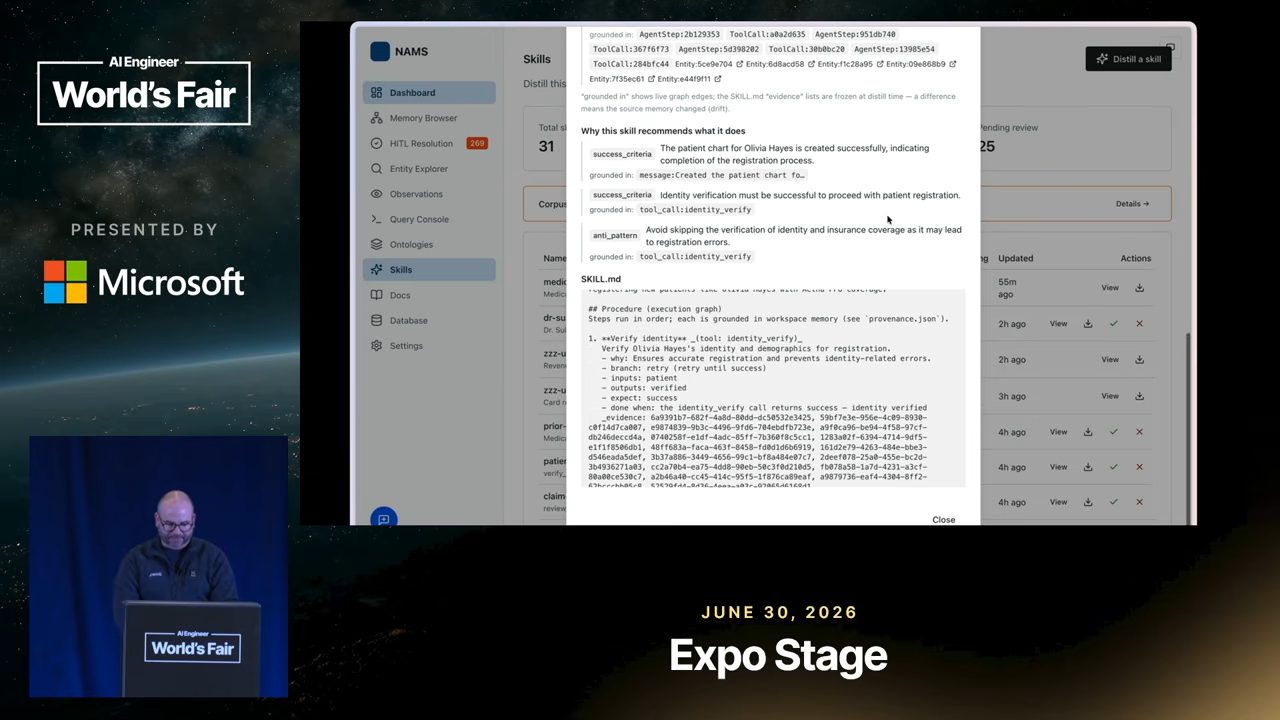
Đây là một bản demo cho phương pháp, không phải bằng chứng rằng hệ thống có thể tự học an toàn trong mọi lĩnh vực. Những nơi có dữ liệu nhạy cảm hoặc quyết định quan trọng càng cần người duyệt và kiểm tra quyền truy cập.
13. Từ một bài nói đến cách làm thực tế
Bài học dễ áp dụng nhất không phải “hãy dựng ngay một graph database”. Có thể bắt đầu bằng một việc lặp lại trong chính công việc của mình: chọn một kết quả tốt, ghi lại đầu vào, từng bước đã làm, công cụ đã dùng, bằng chứng kiểm tra và điểm cần hỏi người phụ trách. Sau đó thử viết thành skill ngắn và chạy lại trên một trường hợp tương tự.
Nếu làm lại mà agent vẫn phải đoán nhiều, skill còn thiếu. Nếu quy trình chỉ đúng với một ca đặc biệt, đừng vội biến nó thành luật chung. Nếu công cụ hoặc dữ liệu đổi, cần có người chịu trách nhiệm sửa và duyệt bản mới.
Trí nhớ cho agent biết chuyện gì đã xảy ra. Skill giúp nó biết phải làm gì. Bằng chứng và kiểm tra giúp ta biết có nên tin cách làm ấy hay không.
Xem video bài nói của Will Lyon.